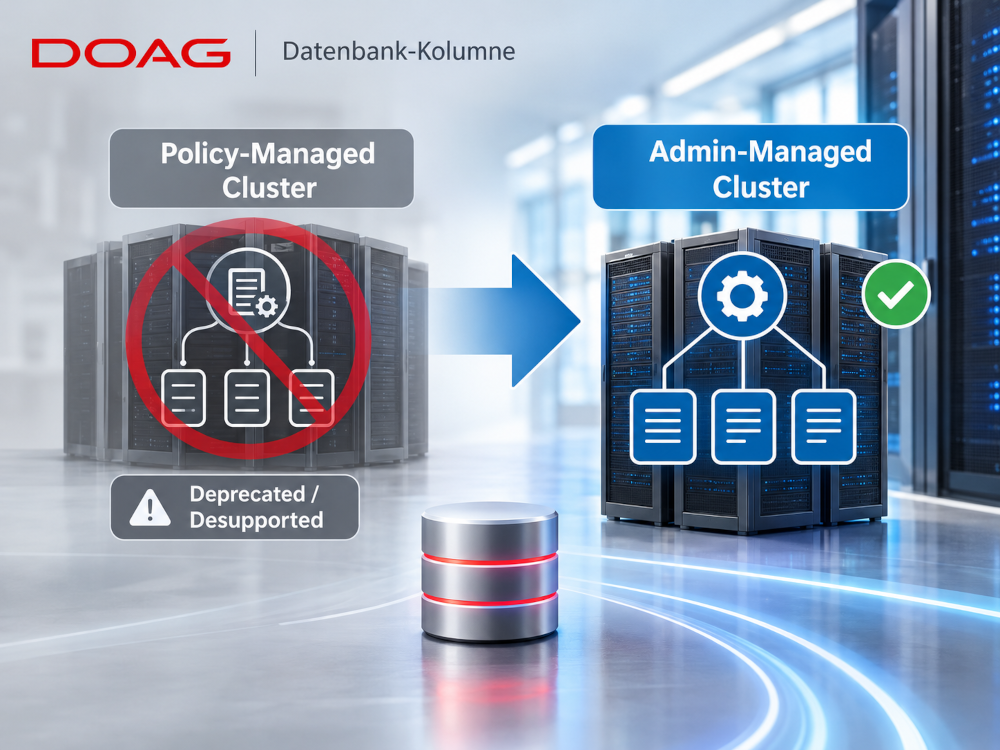
Laut den Oracle AI Database 26ai Release Notes wird die Policy-Managed-Datenbank-Deployment-Option nicht mehr supported.
Policy-managed databases were deprecated in Oracle Database 21c, and admin-managed database deployment was enhanced with functions similar to policy managed databases. By converging the automation provided by policy-managed database with the consistency of an admin-managed database, Oracle seeks to simplify database management tasks for database administrators. This converged database deployment provides the best of both options, such as providing the options to rank and define the order of database startup, without requiring you to choose a specific style during deployment.
Was ist der Unterschied zwischen Policy-Managed- und Admin-Managed-Cluster-Setups?
Im Policy-Managed-Deployment-Modus legt der Clusteradministrator fest, wie viele Ressourcen (Datenbankinstanzen) basierend auf Bedingungen (Richtlinien) gestartet werden. Es ist nicht definiert, wo diese Instanzen gestartet werden. Üblicherweise werden die Cluster für eine solche Einrichtung in Serverpools unterteilt, und die Datenbankinstanzen können innerhalb der Grenzen eines solchen Pools frei gestartet oder gestoppt werden. Der Server, auf welchem eine Instanz startet, wird erst zu diesem Zeitpunkt festgelegt. Die Pools können vergrößert oder verkleinert werden, ohne die Konfiguration der Datenbankinstanz zu ändern.
Im Gegensatz hierzu definiert der Clusteradministrator im Admin-Managed-Deployment-Modus ein Mapping zwischen den zu startenden Datenbankinstanzen und -services und den verfügbaren Servern im Cluster. Das Konzept des Serverpools gibt es hier nicht.
Der folgende Text beschreibt im Überblick, wie ein Policy-Managed-Cluster in einen Admin-Managed-Cluster umkonfiguriert werden kann.
Inventur und Backup
Die Codeschnipsel im Folgenden beziehen sich auf einen 2-Knoten-RAC-Cluster. Da im Folgenden alle Datenbank-relevanten Clusterressourcen gelöscht werden, ist ein Backup der Metadaten erforderlich.
Die Inventur, beziehungsweise das Backup muss folgende Informationen sichern:
- Liste aller Database Unique Names (${DBUN}
- Pro DB: UNDO-Tablespaces
- Pro DB: Lokation des spfile
- ORACLE_HOME(s)
- Pro DB: Lokation des Password-Files
- Pro DB: Abhängigkeiten von Diskgruppen oder Filesystemen
- Liste aller Oracle Database Services mit ihrer Kardinalität (sofern als Cluster-Ressource definiert)
- Zuordnung der Database Services zu Pluggable Databases (leider in 19c noch keine Cluster-Ressourcen)
${ORACLE_HOME}/bin/srvctl config database -d ${DBUN}
>${WORKDIR}/${DBUN}/${DBUN}.cfg
${ORACLE_HOME}/bin/srvctl getenv database -d ${DBUN}
>${WORKDIR}/${DBUN}/${DBUN}.getenv
${ORACLE_HOME}/bin/srvctl config service -d ${DBUN}
>${WORKDIR}/${DBUN}/${DBUN}.svc
${GRID_HOME}/bin/crsctl stat res ora.${DBUN}.db -f
>${WORKDIR}/${DBUN}/${DBUN}.var
${GRID_HOME}/bin/crsctl stat res ora.${DBUN.${service_name}.svc -f
>${WORKDIR}/${DBUN}/${service_name}.var
UNDO-Tablespaces
Da in der Policy-Managed-Architektur die UNDO-Tablespaces erst beim Start der Instanz angelegt werden, müssen wir nun dafür sorgen, daß die fehlenden UNDO-Tablespaces nun im Voraus angelegt werden, entsprechend der geplanten Anzahl von Instanzen pro Datenbank in der Admin-Managed-Architektur.
Vorbereitung der spfile(s)
In Offline-Backups der spfile(s) müssen folgende statische Einträge definiert werden, welche die Instanznamen und -nummern, die Anzahl der Redolog-Threads sowie die Zuordnung der UNDO-Tablespaces zu den Instanzen definieren.
${DBUN}1.instance_name='${DBUN}1'
${DBUN}2.instance_name='${DBUN}2'
${DBUN}1.instance_number=1
${DBUN}2.instance_number=2
${DBUN}1.thread=1
${DBUN}2.thread=2
${DBUN}1.undo_tablespace='undo01'
${DBUN}2.undo_tablespace='undo02'
Löschen der Clusterressourcen und Serverpools
Alle Datenbanken und Services müssen nun gestoppt und die Clusterressourcen gelöscht werden.
srvctl stop database -db ${DBUN}
srvctl remove database -db ${DBUN}
srvctl status serverpool
Server pool name: Free
Active servers count: 0
Server pool name: Generic
Active servers count: 0
Server pool name: p1
Active servers count: 2
srvctl remove serverpool -serverpool p1
# All servers must appear in the pool Free.
srvctl status serverpool
Server pool name: Free
Active servers count: 2
Server pool name: Generic
Active servers count: 0
Neuanlegen der Clusterressourcen
Mit Hilfe unserer Backupdaten werden nun alle gelöschten Clusterressourcen neu im Admin-Managed-Stil angelegt.
srvctl add database -db ${DBUN}
-pwfile +${DATA}/${DBUN}/orapw${DBUN}
-oraclehome ${ORACLE_HOME}
-spfile +${DATA}/${DBUN}/spfile${DBUN}.ora
-dbname ${DB_NAME}
-policy automatic
srvctl modify database -db ${DBUN} -diskgroup “${DATA},${FRA}”
srvctl add instance -d ${DBUN} -i ${DBUN}1 -n ${NODE_1}
srvctl add instance -d ${DBUN} -i ${DBUN}2 -n ${NODE_2}
srvctl setenv database -d ${DBUN} -t "ORACLE_UNQNAME=${DBUN}"
srvctl setenv database -d ${DBUN} -t "ORACLE_BASE=/app/oracle"
srvctl setenv database -d ${DBUN} -t
"TNS_ADMIN=/app/oracle/admin/${DBUN}/network/pfile"
srvctl add service -db ${DBUN} -preferred "${DBUN}1,${DBUN}2" -pdb
<pdb_name> -service <service name> -role primary-policy automatic -
failover_restore level1 -drain_timeout 300
Refresh der spfile(s)
Die weiter oben modifizierten Offline-Kopien der spfile(s) werden nun an den richtigen Lokationen als spfiles bereitgestellt.
sqlplus /nolog <<EOF${DBUN}
connect / as sysdba
startup nomount pfile='${WORKDIR}/${DBUN}/pfile.ora';
create spfile='+${DATA}/${DBUN}/spfile${DBUN}.ora' from
pfile='${WORKDIR}/${DBUN}/pfile.ora';
shutdown immediate;
exit;
EOF${DBUN}
Start der Clusterressourcen
Letztendlich können nun alle Clusterressourcen gestartet werden.
srvctl start database -db ${DBUN}
Automatisierung
Die gesamte Prozedur lässt sich sehr gut automatisieren, so dass die Downtime, auch bei sehr großen Clustern mit vielen Ressourcen kurz gehalten werden kann.
Matthias Mann